
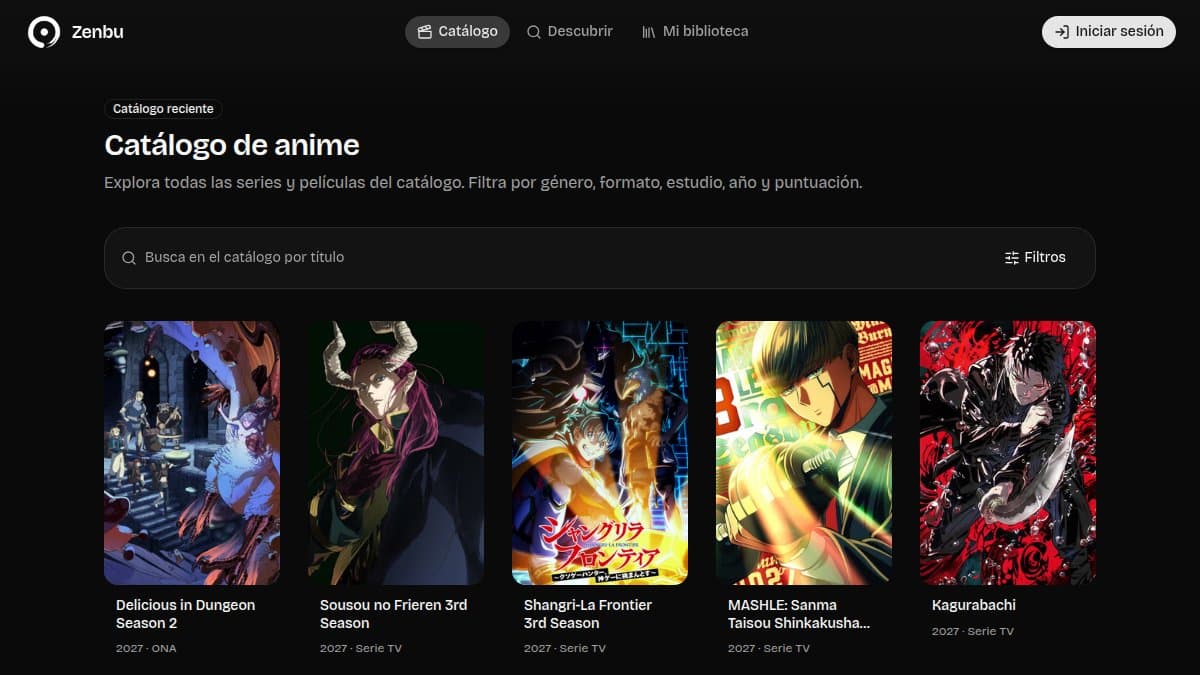
Zenbu empezó con una frase que no sabíamos buscar: "algo tranquilo, de alguien que viaja solo y ayuda a la gente". Cualquiera que haya visto Mushishi sabe cuál es. Ningún catálogo de anime te la da, porque todos buscan por título, por género o por etiqueta, y esa frase no tiene ni título ni género.
Lo hicimos entre dos. Julio Zaragoza y yo, como su TFG, y de los 134 commits que hay en main más o menos la mitad son suyos. Lo digo al principio porque en este blog escribo en primera persona y aquí casi todo es "hicimos".
Un vector por serie, y nada más
La primera decisión fue la más aburrida y la que más tiempo nos ahorró: nada de trocear. Cada anime es un único documento de menos de 500 tokens y un único vector. El documento se monta con una plantilla fija:
`${title} (${english}). ${format}, ${year}. ${synopsis}. ${genres}. Themes: ${tags}`
Los tags son lo que la documentación del proyecto llama la señal de "vibe". Entran solo los que AniList puntúa con rango 50 o más y que no son spoilers. Una sinopsis te dice de qué va una serie. Los tags te dicen cómo se siente, que es justo lo que queríamos buscar.
Los documentos están en inglés y las búsquedas llegan en castellano. No hay paso de traducción. Los embeddings multilingües (usamos text-embedding-3-small, 1536 dimensiones) acercan "alguien que viaja solo" a "a wandering loner" sin ayuda. Traducir cada consulta habría sido una llamada más en serie y un sitio más donde romperse.
El catálogo sale de la API GraphQL de AniList, y lo que aprendimos de ella lo aprendimos a base de pegarnos. El máximo real es de 50 resultados por página. El rate limit real son 30 peticiones por minuto, no las 90 que anuncian. Y hay un tope duro de 5.000 resultados por combinación de filtros, así que la ingesta va troceada por año y temporada. El JSON crudo se guarda en disco para poder reprocesar con --skip-fetch sin volver a pedirle nada a AniList. Hoy hay 14.470 fichas, de 1960 a 2027.
Para no pagar dos veces lo mismo, cada fila guarda un hash del nombre del modelo más el texto del documento. Si el hash no cambia, no se vuelve a embeber. El cálculo inicial era que 30.000 animes a 400 tokens salían por menos de un dólar, así que la motivación no era el dinero. Era poder cambiar la plantilla del documento y reingerir en minutos, no en horas.
La búsqueda: dos listas, una fusión y un juez
Una búsqueda de texto hace cuatro cosas en orden:
- Búsqueda léxica con
tsvectorde Postgres. - Búsqueda vectorial sobre un índice HNSW (coseno,
m=16,ef_construction=200). - Fusión de las dos listas con RRF, con
k = 60. - Un LLM (
gpt-5.4-mini) recibe el conjunto fusionado y devuelve los ids reordenados en un JSON con esquema.
Si el reranker falla, se devuelve el orden fusionado. Si no hay clave de OpenAI, se degrada a búsqueda léxica sola. La búsqueda nunca se queda en blanco por culpa de un proveedor.
El reranker se diseñó detrás de una bandera, como algo opcional que activaríamos "si hacía falta". Una semana después quitamos la bandera, porque los números no dejaban discusión (ahora los cuento). Una trampa de camino: gpt-5.4-mini rechaza el parámetro temperature, y lo que sustituye esa perilla es reasoning_effort: low.
"Parecidos a este" no usa nada de eso. Lee el vector ya guardado de la serie de origen y busca vecinos. El vector va en un CTE materializado para que Postgres use el índice HNSW en vez de recorrer la tabla. En la base de datos tarda un milisegundo. El viaje de ida y vuelta a Neon son unos 55.
El problema de verdad: las secuelas
Montamos un conjunto de evaluación con 20 casos, entre frases en lenguaje natural, sinopsis pegadas y "parecidos a". Sin reranker, hit@5 salía en 0,842. Parecía bastante bueno hasta que miramos los fallos uno a uno.
El caso que lo explica todo es Mob Psycho 100 III. Para una consulta que describía su premisa, salía en el puesto 83. Su sinopsis en AniList es, literalmente, "la tercera temporada de…". No hay nada que buscar ahí. Una buena parte del catálogo son segundas y terceras temporadas y películas de franquicia, y muchas tienen el mismo problema: el texto que describe la historia está en la primera temporada, no en la que tú quieres encontrar.
Lo arreglamos en el documento, no en la búsqueda. Un LLM sintetiza una "premisa de franquicia" (161 en total) y se antepone al documento de cada entrega. Mob Psycho 100 III pasó del 83 al 14 en ranking vectorial puro y al 1 después del reranker. Con las premisas reingeridas, el conjunto de evaluación quedó en hit@5 de 1,0, MRR de 0,965 y recall@25 de 1,0. Veinte casos son pocos para presumir de ese 1,0, y lo sabemos. Lo que sí nos dicen es que el fallo estaba en los datos y no en el algoritmo.
El mismo conjunto de evaluación nos pilló un error propio. Los resultados que solo venían de la rama vectorial se etiquetaban como "léxicos", y eso torcía todas las conclusiones sobre qué rama aportaba. Arreglado el etiquetado, la conclusión fue incómoda: el top 5 es prácticamente todo vectorial. La rama léxica aporta muy poco. La mantenemos porque es la red de seguridad cuando OpenAI no responde, no porque mejore los resultados.
Lo que no está resuelto
La búsqueda de texto tarda unos 3 segundos de punta a punta. Casi todo es esperar a dos llamadas a OpenAI en serie: el embedding de la consulta y el reranker. Hay una caché en Postgres diseñada y sin implementar. Neon no permite extensiones de caché en memoria y pg_cron no es fiable cuando el cómputo escala a cero, así que la caché tiene que vivir en tablas normales y caducar sola. Está en el plan y no en producción.
Las cuotas sí están. Cada reserva de búsqueda es atómica en SQL, con un advisory lock por usuario, y la misma petición repetida en tres minutos no cuenta dos veces. Un visitante sin cuenta tiene 10 búsquedas al año, identificado por una cookie firmada y no por IP. Con cuenta son 30 al mes y con Premium, 200. Cuesta bastante menos poner un límite desde el primer día que explicar una factura de OpenAI después.
Si tuviera que quedarme con una sola cosa de Zenbu, sería esta. Pensaba que el trabajo iba a ser la búsqueda semántica, y la búsqueda semántica fue la parte fácil. Lo difícil fue mirar uno a uno los casos que fallaban y descubrir que el problema eran fichas sin nada que buscar. Ahora, antes de tocar un modelo, abro los datos.